
CocoIndex
Indexer en embeddings des documents stockés dans un bucket RustFS avec CocoIndex.
Ce guide connecte CocoIndex — le moteur d'indexation incrémentale pour pipelines IA — à RustFS comme source de documents. Vous allez construire un flux qui liste des fichiers markdown depuis un préfixe de bucket, les découpe et en calcule les embeddings, stocke les embeddings dans Postgres, puis interroge l'index. Le workflow a été vérifié avec CocoIndex 1.0.26 lisant depuis un bucket RustFS via un point de terminaison S3 personnalisé.
Vous avez besoin de Python 3.11+ et d'un Postgres avec l'extension pgvector pour la cible et l'état du flux.
Schéma d’architecture
CocoIndex lit les objets sources via un client aiobotocore que vous créez vous-même, donc tout point de terminaison compatible S3 fonctionne — y compris RustFS avec l'adressage path-style. Les mises à jour incrémentales ne retraitent que les fichiers dont le contenu a changé, indexés par des chemins S3 stables.
Préparer l'environnement
Installez CocoIndex avec le connecteur S3 et la pile d'embedding :
python3 -m venv .venv
./.venv/bin/pip install torch --index-url https://download.pytorch.org/whl/cpu
./.venv/bin/pip install "cocoindex[amazon_s3]" asyncpg pgvector numpy python-dotenv sentence-transformers
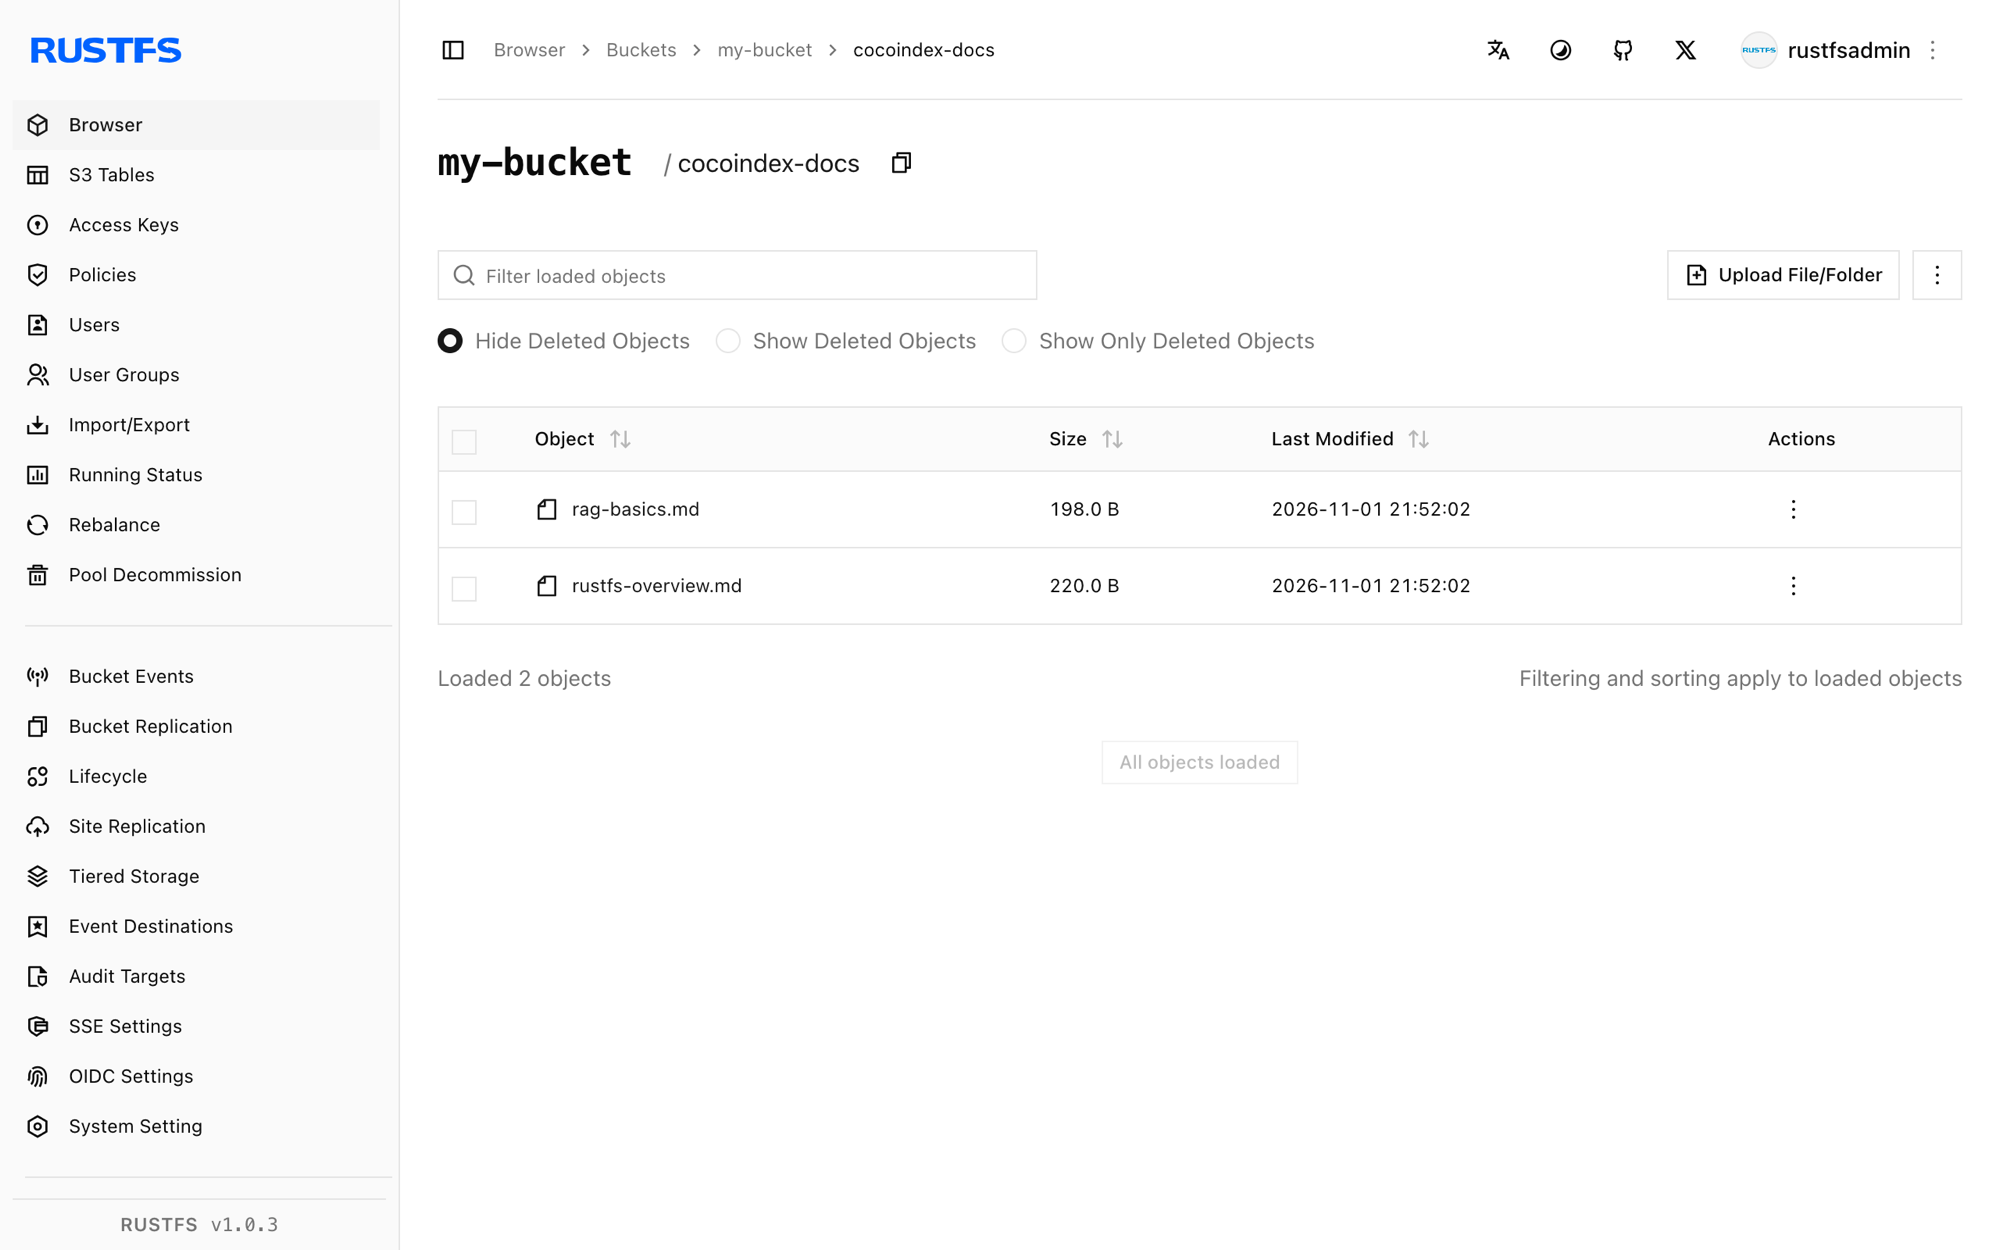
Téléversez les documents sources dans un préfixe de bucket, en remplaçant toutes les valeurs de connexion indicatives :
aws s3 cp ./docs s3://my-bucket/cocoindex-docs/ --recursive \
--endpoint-url http://<your-rustfs-endpoint>:9000upload: docs/rag-basics.md to s3://my-bucket/cocoindex-docs/rag-basics.md
upload: docs/rustfs-overview.md to s3://my-bucket/cocoindex-docs/rustfs-overview.mdÉcrire le flux
Créez le fichier d'environnement et le flux. Le client S3 est créé avec AWS_ENDPOINT_URL défini, que aiobotocore honore pour les points de terminaison compatibles S3 :
S3_BUCKET=my-bucket
S3_PREFIX=cocoindex-docs/
AWS_ENDPOINT_URL=http://<your-rustfs-endpoint>:9000
AWS_ACCESS_KEY_ID=<your-access-key>
AWS_SECRET_ACCESS_KEY=<your-secret-key>
AWS_DEFAULT_REGION=us-east-1
COCOINDEX_DB=postgres://cocoindex:cocoindex@localhost:5432/cocoindex
POSTGRES_URL=postgres://cocoindex:cocoindex@localhost:5432/cocoindeximport asyncio, os, sys
from dataclasses import dataclass
from typing import AsyncIterator, Annotated
import aiobotocore.session
import asyncpg
from dotenv import load_dotenv
from numpy.typing import NDArray
from pgvector.asyncpg import register_vector
load_dotenv()
import cocoindex as coco
from cocoindex.connectors import amazon_s3, postgres
from cocoindex.ops.sentence_transformers import SentenceTransformerEmbedder
from cocoindex.ops.text import RecursiveSplitter
from cocoindex.resources.chunk import Chunk
from cocoindex.resources.file import PatternFilePathMatcher
DATABASE_URL = os.environ["POSTGRES_URL"]
TABLE_NAME = "rustfs_doc_embeddings"
PG_SCHEMA_NAME = "coco_examples"
S3_BUCKET = os.environ["S3_BUCKET"]
S3_PREFIX = os.getenv("S3_PREFIX", "")
EMBED_MODEL = "sentence-transformers/all-MiniLM-L6-v2"
PG_DB = coco.ContextKey[asyncpg.Pool]("db")
S3_CLIENT = coco.ContextKey[object]("s3_client")
EMBEDDER = coco.ContextKey[SentenceTransformerEmbedder]("embedder", detect_change=True)
_splitter = RecursiveSplitter()
@coco.lifespan
async def coco_lifespan(builder: coco.EnvironmentBuilder) -> AsyncIterator[None]:
async with asyncpg.create_pool(DATABASE_URL, init=register_vector) as pool:
builder.provide(PG_DB, pool)
builder.provide(EMBEDDER, SentenceTransformerEmbedder(EMBED_MODEL))
session = aiobotocore.session.get_session()
async with session.create_client("s3") as s3_client:
builder.provide(S3_CLIENT, s3_client)
yield
@dataclass
class DocEmbedding:
id: int
filename: str
text: str
embedding: Annotated[NDArray, EMBEDDER]
@coco.fn
async def process_chunk(chunk: Chunk, filename: str, table: postgres.TableTarget[DocEmbedding]) -> None:
table.declare_row(row=DocEmbedding(
id=abs(hash(f"{filename}:{chunk.start.char_offset}")) % (10 ** 9),
filename=filename, text=chunk.text,
embedding=await coco.use_context(EMBEDDER).embed(chunk.text),
))
@coco.fn(memo=True)
async def process_file(file: amazon_s3.S3File, table: postgres.TableTarget[DocEmbedding]) -> None:
text = await file.read_text()
chunks = _splitter.split(text, chunk_size=2000, chunk_overlap=500, language="markdown")
await coco.map(process_chunk, chunks, file.file_path.path.as_posix(), table)
@coco.fn
async def app_main() -> None:
target_table = await postgres.mount_table_target(
PG_DB, table_name=TABLE_NAME,
table_schema=await postgres.TableSchema.from_class(DocEmbedding, primary_key=["id"]),
pg_schema_name=PG_SCHEMA_NAME,
)
client = coco.use_context(S3_CLIENT)
files = amazon_s3.list_objects(client, S3_BUCKET, prefix=S3_PREFIX,
path_matcher=PatternFilePathMatcher(included_patterns=["**/*.md"]))
await coco.mount_each(process_file, files.items(), target_table)
app = coco.App(coco.AppConfig(name="RustFSDocs"), app_main)
TOP_K = 5
async def query_once(
pool: asyncpg.Pool,
embedder: SentenceTransformerEmbedder,
query: str,
*,
top_k: int = TOP_K,
) -> None:
query_vec = await embedder.embed(query)
async with pool.acquire() as conn:
rows = await conn.fetch(
f"""
SELECT filename, text, embedding <=> $1 AS distance
FROM "{PG_SCHEMA_NAME}"."{TABLE_NAME}"
ORDER BY distance ASC
LIMIT $2
""",
query_vec,
top_k,
)
for r in rows:
score = 1.0 - float(r["distance"])
print(f"[{score:.3f}] {r['filename']}")
print(f" {r['text']}")
print("---")
async def query(initial_query: str | None = None) -> None:
embedder = SentenceTransformerEmbedder(EMBED_MODEL)
async with asyncpg.create_pool(DATABASE_URL, init=register_vector) as pool:
if initial_query is not None:
await query_once(pool, embedder, initial_query)
return
while True:
q = input("Enter search query (or Enter to quit): ").strip()
if not q:
break
await query_once(pool, embedder, q)
if __name__ == "__main__":
initial = " ".join(sys.argv[1:]) if len(sys.argv) > 1 else None
asyncio.run(query(initial))Construire l'index depuis RustFS
set -a && . ./.env && set +a
./.venv/bin/cocoindex update main✅ app_main: 1 total | 1 added
✅ process_file: 2 total | 2 addedLes deux fichiers markdown ont été lus depuis le bucket RustFS, découpés et transformés en embeddings dans Postgres. Interrogez l'index via le point d'entrée de main.py. Le script charge .env, calcule l'embedding de la question avec le même modèle et affiche les chunks les plus proches :
./.venv/bin/python main.py "what does RustFS expose"[0.163] rag-basics.md
Retrieval augmented generation combines a retriever and a generator.
---La requête atteint des chunks dont la source de vérité est le bucket — modifiez un fichier dans RustFS puis relancez cocoindex update main pour ré-indexer incrémentalement le seul changement.
Arrêter ou réinitialiser
Supprimer les documents indexés :
aws s3 rm s3://my-bucket/cocoindex-docs --recursive \
  --endpoint-url http://<your-rustfs-endpoint>:9000
Dépannage
Environment settings must provide Settings.db_path
CocoIndex conserve son propre état dans Postgres. Définissez COCOINDEX_DB (et POSTGRES_URL pour la cible) vers une base avec l'extension pgvector activée.
InvalidAccessKeyId ou des délais d'attente de connexion depuis le flux
Les variables d'environnement n'ont pas été exportées avant l'exécution (set -a && . ./.env && set +a). AWS_ENDPOINT_URL doit inclure le schéma ; les identifiants passent par la paire standard AWS_ACCESS_KEY_ID/AWS_SECRET_ACCESS_KEY.
Le flux ne voit aucun fichier
Vérifiez le préfixe et le filtre — list_objects parcourt S3_PREFIX et filtre selon included_patterns. Confirmez les objets avec aws s3 ls s3://my-bucket/cocoindex-docs/.
Prochaines étapes
- Consultez les notes de compatibilité S3 avant de brancher d'autres sources sur le même bucket.
- Créez des identifiants de production dédiés avec la gestion des clés d'accès.
- Suivez la documentation du connecteur Amazon S3 de CocoIndex pour les filtres de chemins, les limites de taille et les mises à jour en direct.