
CocoIndex
In einem RustFS-Bucket gespeicherte Dokumente mit CocoIndex in Embeddings indexieren.
In dieser Anleitung verbinden Sie CocoIndex — die inkrementelle Indexierungs-Engine für KI-Pipelines — mit RustFS als Dokumentenquelle. Sie bauen einen Flow, der Markdown-Dateien aus einem Bucket-Präfix auflistet, sie in Chunks teilt, Embeddings erzeugt, die Embeddings in Postgres ablegt und den Index abfragt. Der Ablauf wurde mit CocoIndex 1.0.26 verifiziert, das über einen eigenen S3-Endpunkt aus einem RustFS-Bucket liest.
Sie benötigen Python 3.11+ und ein Postgres mit der pgvector-Erweiterung für Ziel und Zustand des Flows.
Architektur
CocoIndex liest Quellobjekte über einen selbst erstellten aiobotocore-Client, daher funktioniert jeder S3-kompatible Endpunkt — auch RustFS mit Path-Style-Adressierung. Inkrementelle Updates verarbeiten nur Dateien mit geändertem Inhalt, verschlüsselt über stabile S3-Pfade.
Umgebung vorbereiten
Installieren Sie CocoIndex mit dem S3-Connector und der Embedding-Stack:
python3 -m venv .venv
./.venv/bin/pip install torch --index-url https://download.pytorch.org/whl/cpu
./.venv/bin/pip install "cocoindex[amazon_s3]" asyncpg pgvector numpy python-dotenv sentence-transformers
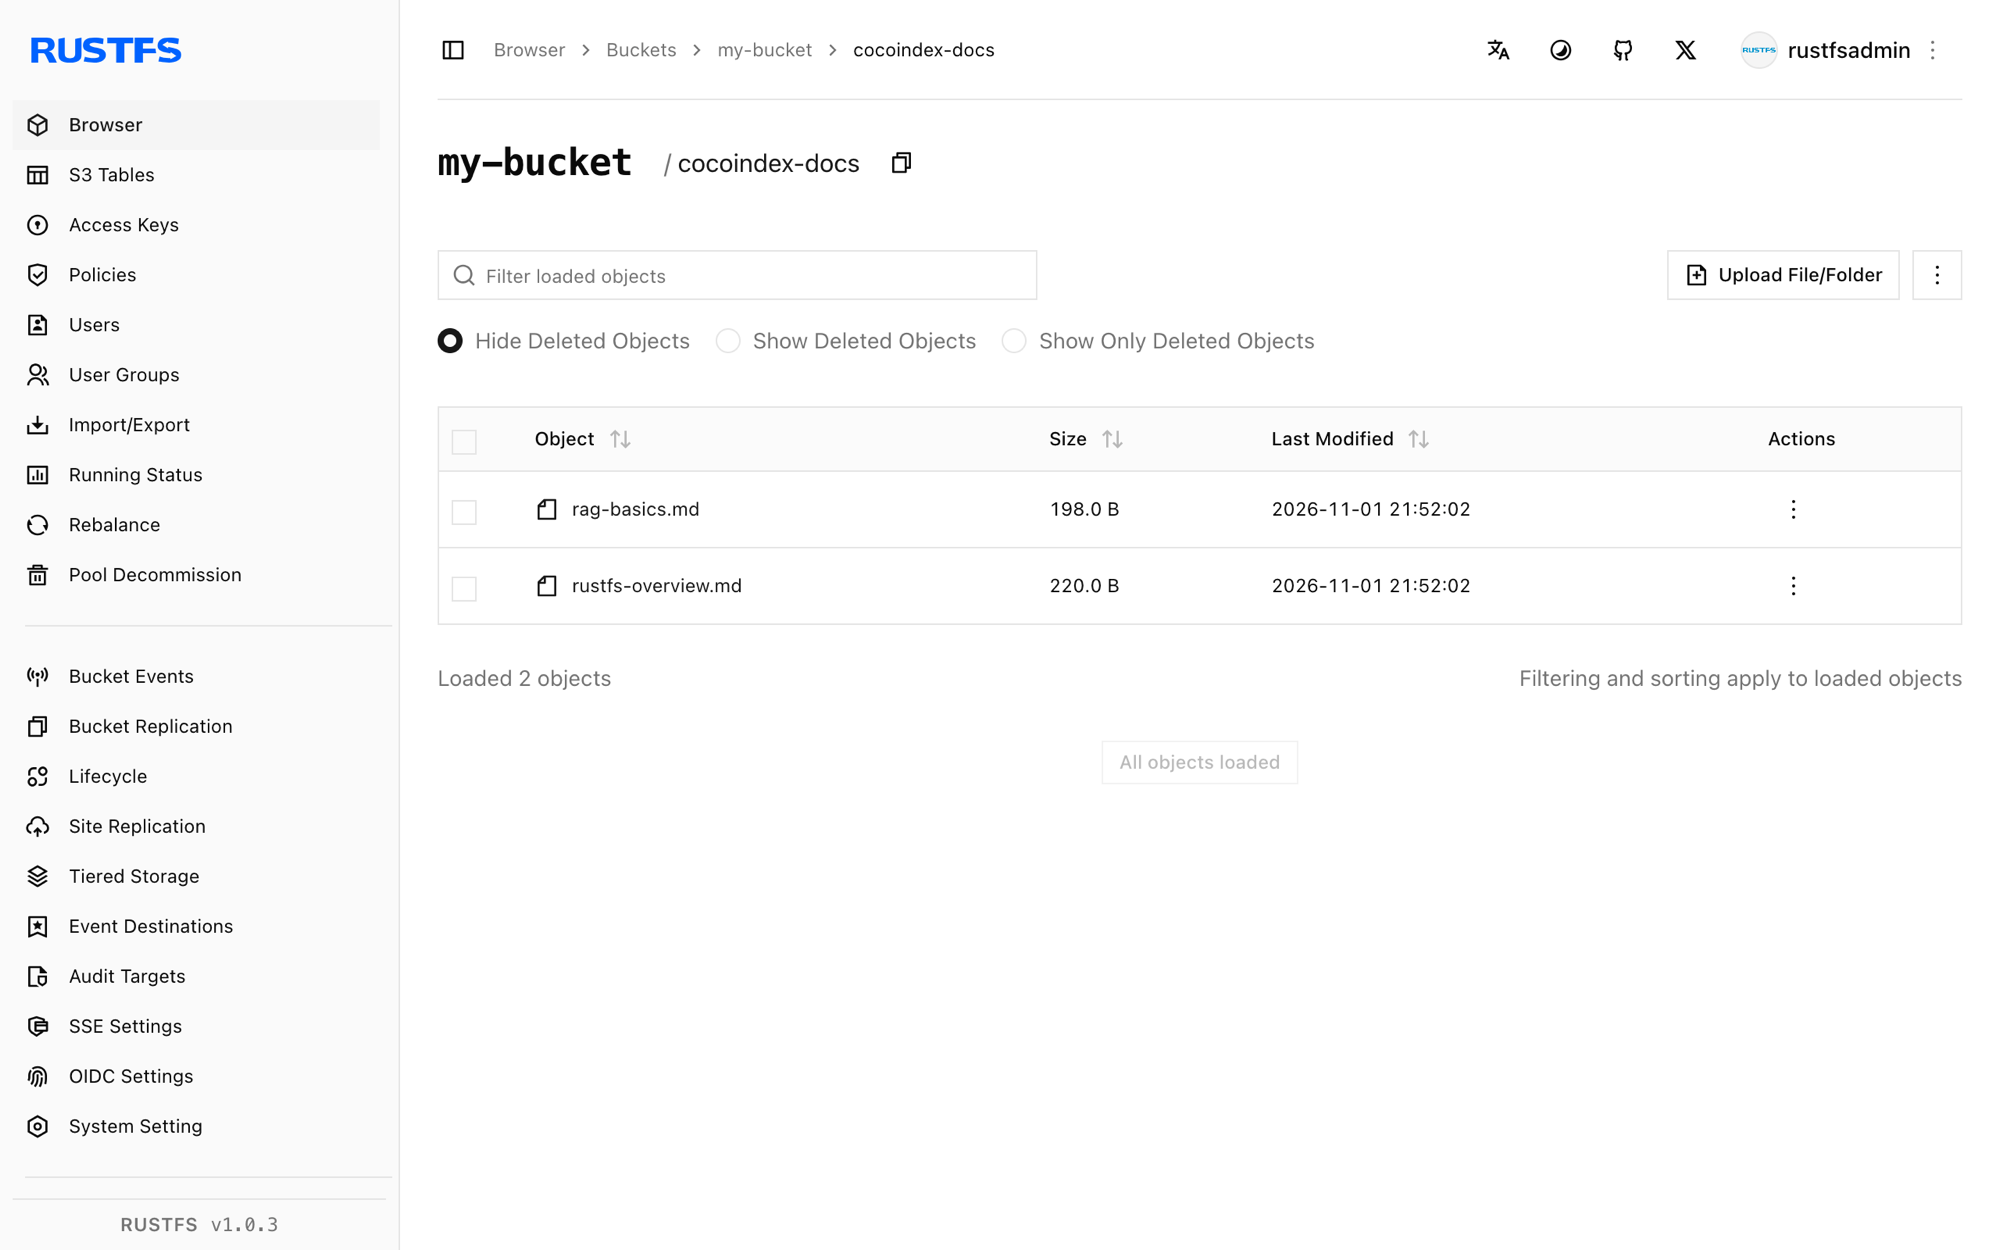
Laden Sie die Quelldokumente in ein Bucket-Präfix hoch. Ersetzen Sie alle Verbindungsplatzhalter:
aws s3 cp ./docs s3://my-bucket/cocoindex-docs/ --recursive \
--endpoint-url http://<your-rustfs-endpoint>:9000upload: docs/rag-basics.md to s3://my-bucket/cocoindex-docs/rag-basics.md
upload: docs/rustfs-overview.md to s3://my-bucket/cocoindex-docs/rustfs-overview.mdDen Flow schreiben
Erstellen Sie die Umgebungsdatei und den Flow. Der S3-Client wird mit gesetztem AWS_ENDPOINT_URL erzeugt — aiobotocore honoriert dies für S3-kompatible Endpunkte:
S3_BUCKET=my-bucket
S3_PREFIX=cocoindex-docs/
AWS_ENDPOINT_URL=http://<your-rustfs-endpoint>:9000
AWS_ACCESS_KEY_ID=<your-access-key>
AWS_SECRET_ACCESS_KEY=<your-secret-key>
AWS_DEFAULT_REGION=us-east-1
COCOINDEX_DB=postgres://cocoindex:cocoindex@localhost:5432/cocoindex
POSTGRES_URL=postgres://cocoindex:cocoindex@localhost:5432/cocoindeximport asyncio, os, sys
from dataclasses import dataclass
from typing import AsyncIterator, Annotated
import aiobotocore.session
import asyncpg
from dotenv import load_dotenv
from numpy.typing import NDArray
from pgvector.asyncpg import register_vector
load_dotenv()
import cocoindex as coco
from cocoindex.connectors import amazon_s3, postgres
from cocoindex.ops.sentence_transformers import SentenceTransformerEmbedder
from cocoindex.ops.text import RecursiveSplitter
from cocoindex.resources.chunk import Chunk
from cocoindex.resources.file import PatternFilePathMatcher
DATABASE_URL = os.environ["POSTGRES_URL"]
TABLE_NAME = "rustfs_doc_embeddings"
PG_SCHEMA_NAME = "coco_examples"
S3_BUCKET = os.environ["S3_BUCKET"]
S3_PREFIX = os.getenv("S3_PREFIX", "")
EMBED_MODEL = "sentence-transformers/all-MiniLM-L6-v2"
PG_DB = coco.ContextKey[asyncpg.Pool]("db")
S3_CLIENT = coco.ContextKey[object]("s3_client")
EMBEDDER = coco.ContextKey[SentenceTransformerEmbedder]("embedder", detect_change=True)
_splitter = RecursiveSplitter()
@coco.lifespan
async def coco_lifespan(builder: coco.EnvironmentBuilder) -> AsyncIterator[None]:
async with asyncpg.create_pool(DATABASE_URL, init=register_vector) as pool:
builder.provide(PG_DB, pool)
builder.provide(EMBEDDER, SentenceTransformerEmbedder(EMBED_MODEL))
session = aiobotocore.session.get_session()
async with session.create_client("s3") as s3_client:
builder.provide(S3_CLIENT, s3_client)
yield
@dataclass
class DocEmbedding:
id: int
filename: str
text: str
embedding: Annotated[NDArray, EMBEDDER]
@coco.fn
async def process_chunk(chunk: Chunk, filename: str, table: postgres.TableTarget[DocEmbedding]) -> None:
table.declare_row(row=DocEmbedding(
id=abs(hash(f"{filename}:{chunk.start.char_offset}")) % (10 ** 9),
filename=filename, text=chunk.text,
embedding=await coco.use_context(EMBEDDER).embed(chunk.text),
))
@coco.fn(memo=True)
async def process_file(file: amazon_s3.S3File, table: postgres.TableTarget[DocEmbedding]) -> None:
text = await file.read_text()
chunks = _splitter.split(text, chunk_size=2000, chunk_overlap=500, language="markdown")
await coco.map(process_chunk, chunks, file.file_path.path.as_posix(), table)
@coco.fn
async def app_main() -> None:
target_table = await postgres.mount_table_target(
PG_DB, table_name=TABLE_NAME,
table_schema=await postgres.TableSchema.from_class(DocEmbedding, primary_key=["id"]),
pg_schema_name=PG_SCHEMA_NAME,
)
client = coco.use_context(S3_CLIENT)
files = amazon_s3.list_objects(client, S3_BUCKET, prefix=S3_PREFIX,
path_matcher=PatternFilePathMatcher(included_patterns=["**/*.md"]))
await coco.mount_each(process_file, files.items(), target_table)
app = coco.App(coco.AppConfig(name="RustFSDocs"), app_main)
TOP_K = 5
async def query_once(
pool: asyncpg.Pool,
embedder: SentenceTransformerEmbedder,
query: str,
*,
top_k: int = TOP_K,
) -> None:
query_vec = await embedder.embed(query)
async with pool.acquire() as conn:
rows = await conn.fetch(
f"""
SELECT filename, text, embedding <=> $1 AS distance
FROM "{PG_SCHEMA_NAME}"."{TABLE_NAME}"
ORDER BY distance ASC
LIMIT $2
""",
query_vec,
top_k,
)
for r in rows:
score = 1.0 - float(r["distance"])
print(f"[{score:.3f}] {r['filename']}")
print(f" {r['text']}")
print("---")
async def query(initial_query: str | None = None) -> None:
embedder = SentenceTransformerEmbedder(EMBED_MODEL)
async with asyncpg.create_pool(DATABASE_URL, init=register_vector) as pool:
if initial_query is not None:
await query_once(pool, embedder, initial_query)
return
while True:
q = input("Enter search query (or Enter to quit): ").strip()
if not q:
break
await query_once(pool, embedder, q)
if __name__ == "__main__":
initial = " ".join(sys.argv[1:]) if len(sys.argv) > 1 else None
asyncio.run(query(initial))Den Index aus RustFS bauen
set -a && . ./.env && set +a
./.venv/bin/cocoindex update main✅ app_main: 1 total | 1 added
✅ process_file: 2 total | 2 addedBeide Markdown-Dateien wurden aus dem RustFS-Bucket gelesen, in Chunks geteilt und nach Postgres embeddet. Fragen Sie den Index über den Einstieg in main.py ab. Das Skript lädt .env, embeddet die Frage mit demselben Modell und gibt die nächsten Chunks aus:
./.venv/bin/python main.py "what does RustFS expose"[0.163] rag-basics.md
Retrieval augmented generation combines a retriever and a generator.
---Die Abfrage trifft Chunks, deren Quelle der Bucket ist — ändern Sie eine Datei in RustFS und führen Sie cocoindex update main erneut aus, um nur die Änderung inkrementell neu zu indexieren.
Anhalten oder Zurücksetzen
Die indexierten Dokumente löschen:
aws s3 rm s3://my-bucket/cocoindex-docs --recursive \
  --endpoint-url http://<your-rustfs-endpoint>:9000
Fehlerbehebung
Environment settings must provide Settings.db_path
CocoIndex hält seinen eigenen Zustand in Postgres. Setzen Sie COCOINDEX_DB (und POSTGRES_URL für das Ziel) auf eine Datenbank mit aktivierter pgvector-Erweiterung.
InvalidAccessKeyId oder Connection-Timeouts aus dem Flow
Die Umgebungsvariablen wurden vor dem Flow-Lauf nicht exportiert (set -a && . ./.env && set +a). AWS_ENDPOINT_URL muss das Schema enthalten; die Zugangsdaten laufen über das Standardpaar AWS_ACCESS_KEY_ID/AWS_SECRET_ACCESS_KEY.
Der Flow sieht keine Dateien
Prüfen Sie Präfix und Matcher — list_objects durchläuft S3_PREFIX und filtert nach included_patterns. Bestätigen Sie die Objekte mit aws s3 ls s3://my-bucket/cocoindex-docs/.
Nächste Schritte
- Lesen Sie vor weiteren Quellen die S3-Kompatibilitätshinweise.
- Erstellen Sie dedizierte Produktionszugangsdaten mit Zugangsdatenverwaltung.
- Folgen Sie der CocoIndex-Amazon-S3-Connector-Dokumentation für Pfad-Matcher, Größenlimits und Live-Updates.